
Sommaire7
L’essentiel
En trente secondes- EnjeuAvant de choisir un moteur de lecture des cartes santé, Santécie devait savoir lequel est fiable, et où les données ont le droit d’aller.
- MécanismeUn noyau commun pilote en NestJS des pipelines Python versionnés, dont chaque exécution produit des artefacts immuables, donc comparables.
- PreuveOnze décisions d’architecture, une analyse des offres OCR sous contrainte HDS et 206 tests automatisés, dans un dépôt dont je suis le seul auteur.
- ImpactSantécie peut trancher entre traitement local, modèle open-weight hébergé et service externe sur des mesures, avant d’engager un fournisseur.
- LimitesC’est un démonstrateur : aucun taux de reconnaissance n’est publié, et il ne revendique ni qualité de production ni conformité médicale.
- Client
 Santécie
- Mon rôle
- Responsable du projet et architecte
- Cadre
- Via un partenaire
 Silico
- Équipe
- Seul · 1 personne
- Technologies
 Python
 NestJS
 Docker
 TypeScript
- Marimo
- OCR
- VLM
Le point de départ
Lire une carte de complémentaire santé paraît simple. En pratique, les formats varient d’un organisme à l’autre, les photos sont prises dans des conditions imparfaites, et surtout les données relèvent de la santé : où elles sont traitées, par qui et pour combien de temps n’est pas un détail d’implémentation1.
HDS, pour hébergement de données de…
HDS, pour hébergement de données de santé : la certification exigée en France pour héberger des données de santé pour le compte d’un tiers. Elle a guidé l’analyse des offres OCR hébergées.
La tentation, sur ce type de sujet, est de brancher le service le plus en vue et de juger sur quelques exemples. Le parti pris du projet est inverse : construire d’abord de quoi comparer, puis choisir.
Ce que j’ai construit
La cible est un outil qui lit la carte sur le poste et propose des champs métier, chacun facultatif et modifiable, qu’une personne vérifie avant toute confirmation. Pour choisir le moteur qui le rendra possible, j’ai d’abord construit le banc d’essai.
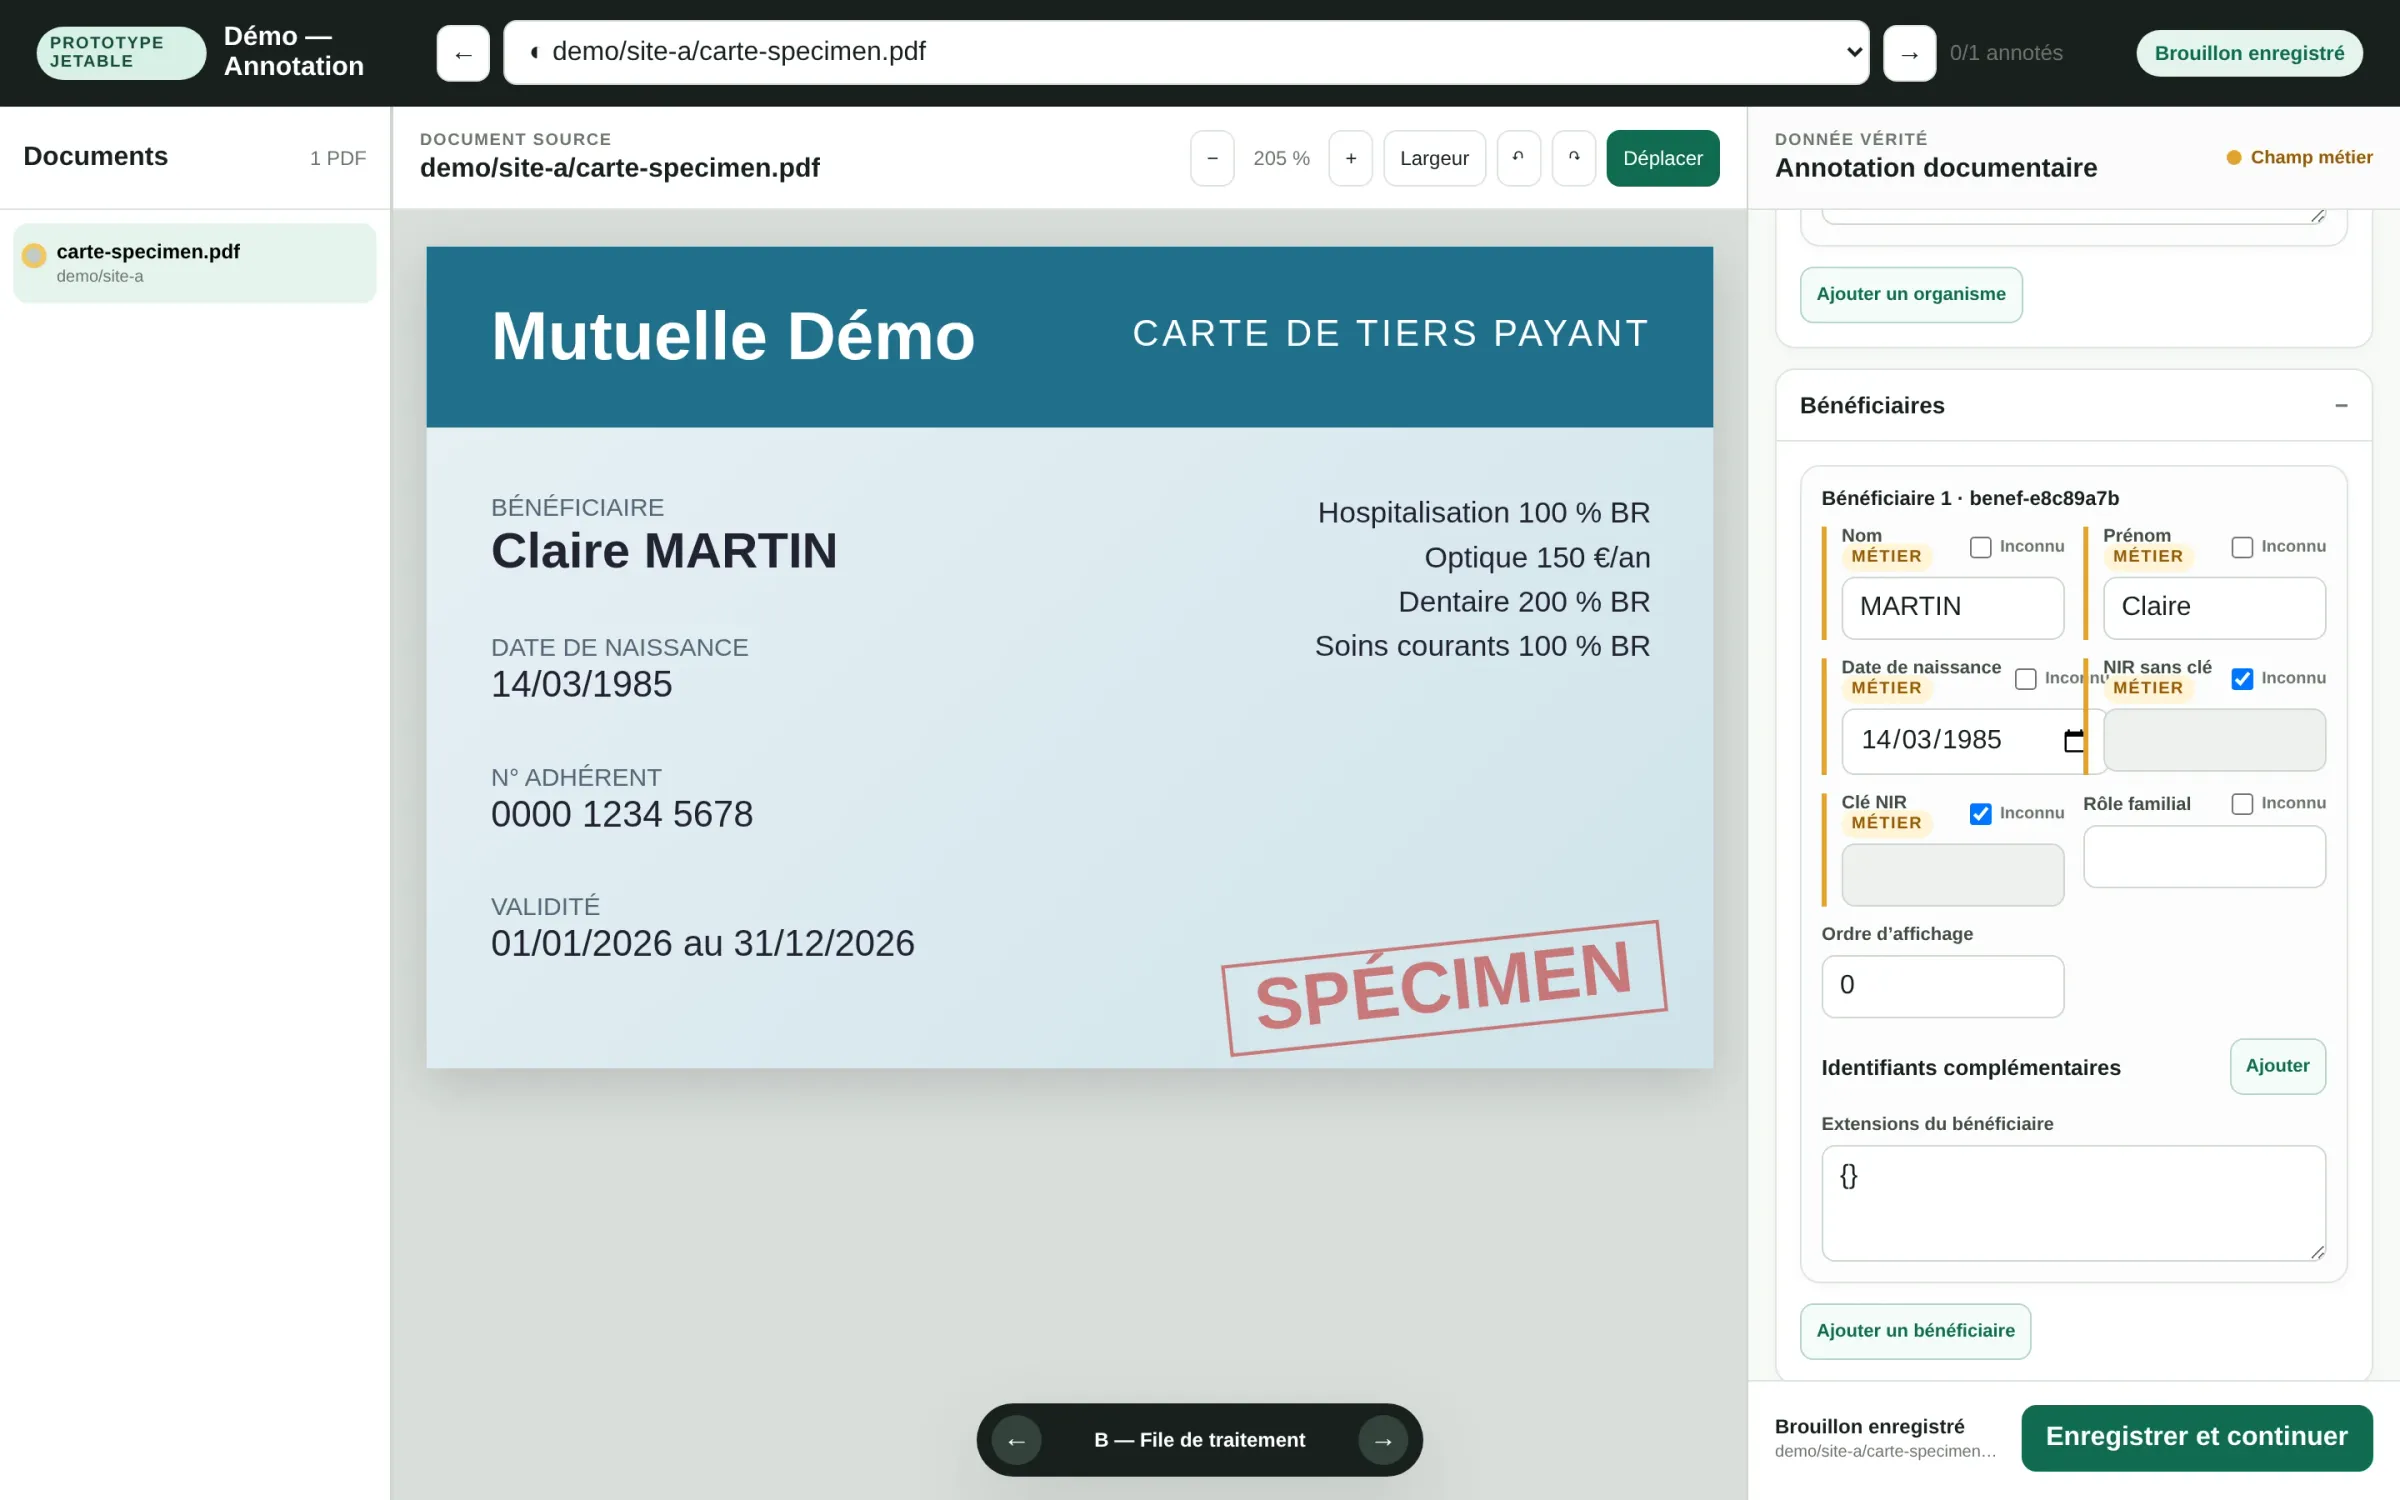
Chaque pipeline y est versionné et produit des artefacts qui ne changent plus : on compare deux moteurs, ou deux réglages, sans ambiguïté. J’ai séparé le pilotage (NestJS) de l’exécution (Python) et isolé l’inférence des workers, pour changer de modèle sans toucher au reste. Un outil d’annotation construit la vérité de référence, champ par champ, sur des cartes spécimens.
Ce que montrent les preuves
Une part importante du travail est écrite : les décisions d’architecture, une analyse des fournisseurs OCR hébergés et de leurs engagements de confidentialité, des notes sur l’inférence de modèles open-weight. Elles permettent au client de comprendre pourquoi une option est retenue ou écartée, et à un nouveau développeur de reprendre le projet sans tout redécouvrir2.
Seul auteur du dépôt : 207 commits…
Seul auteur du dépôt : 207 commits, du 14 août au 5 octobre 2026.
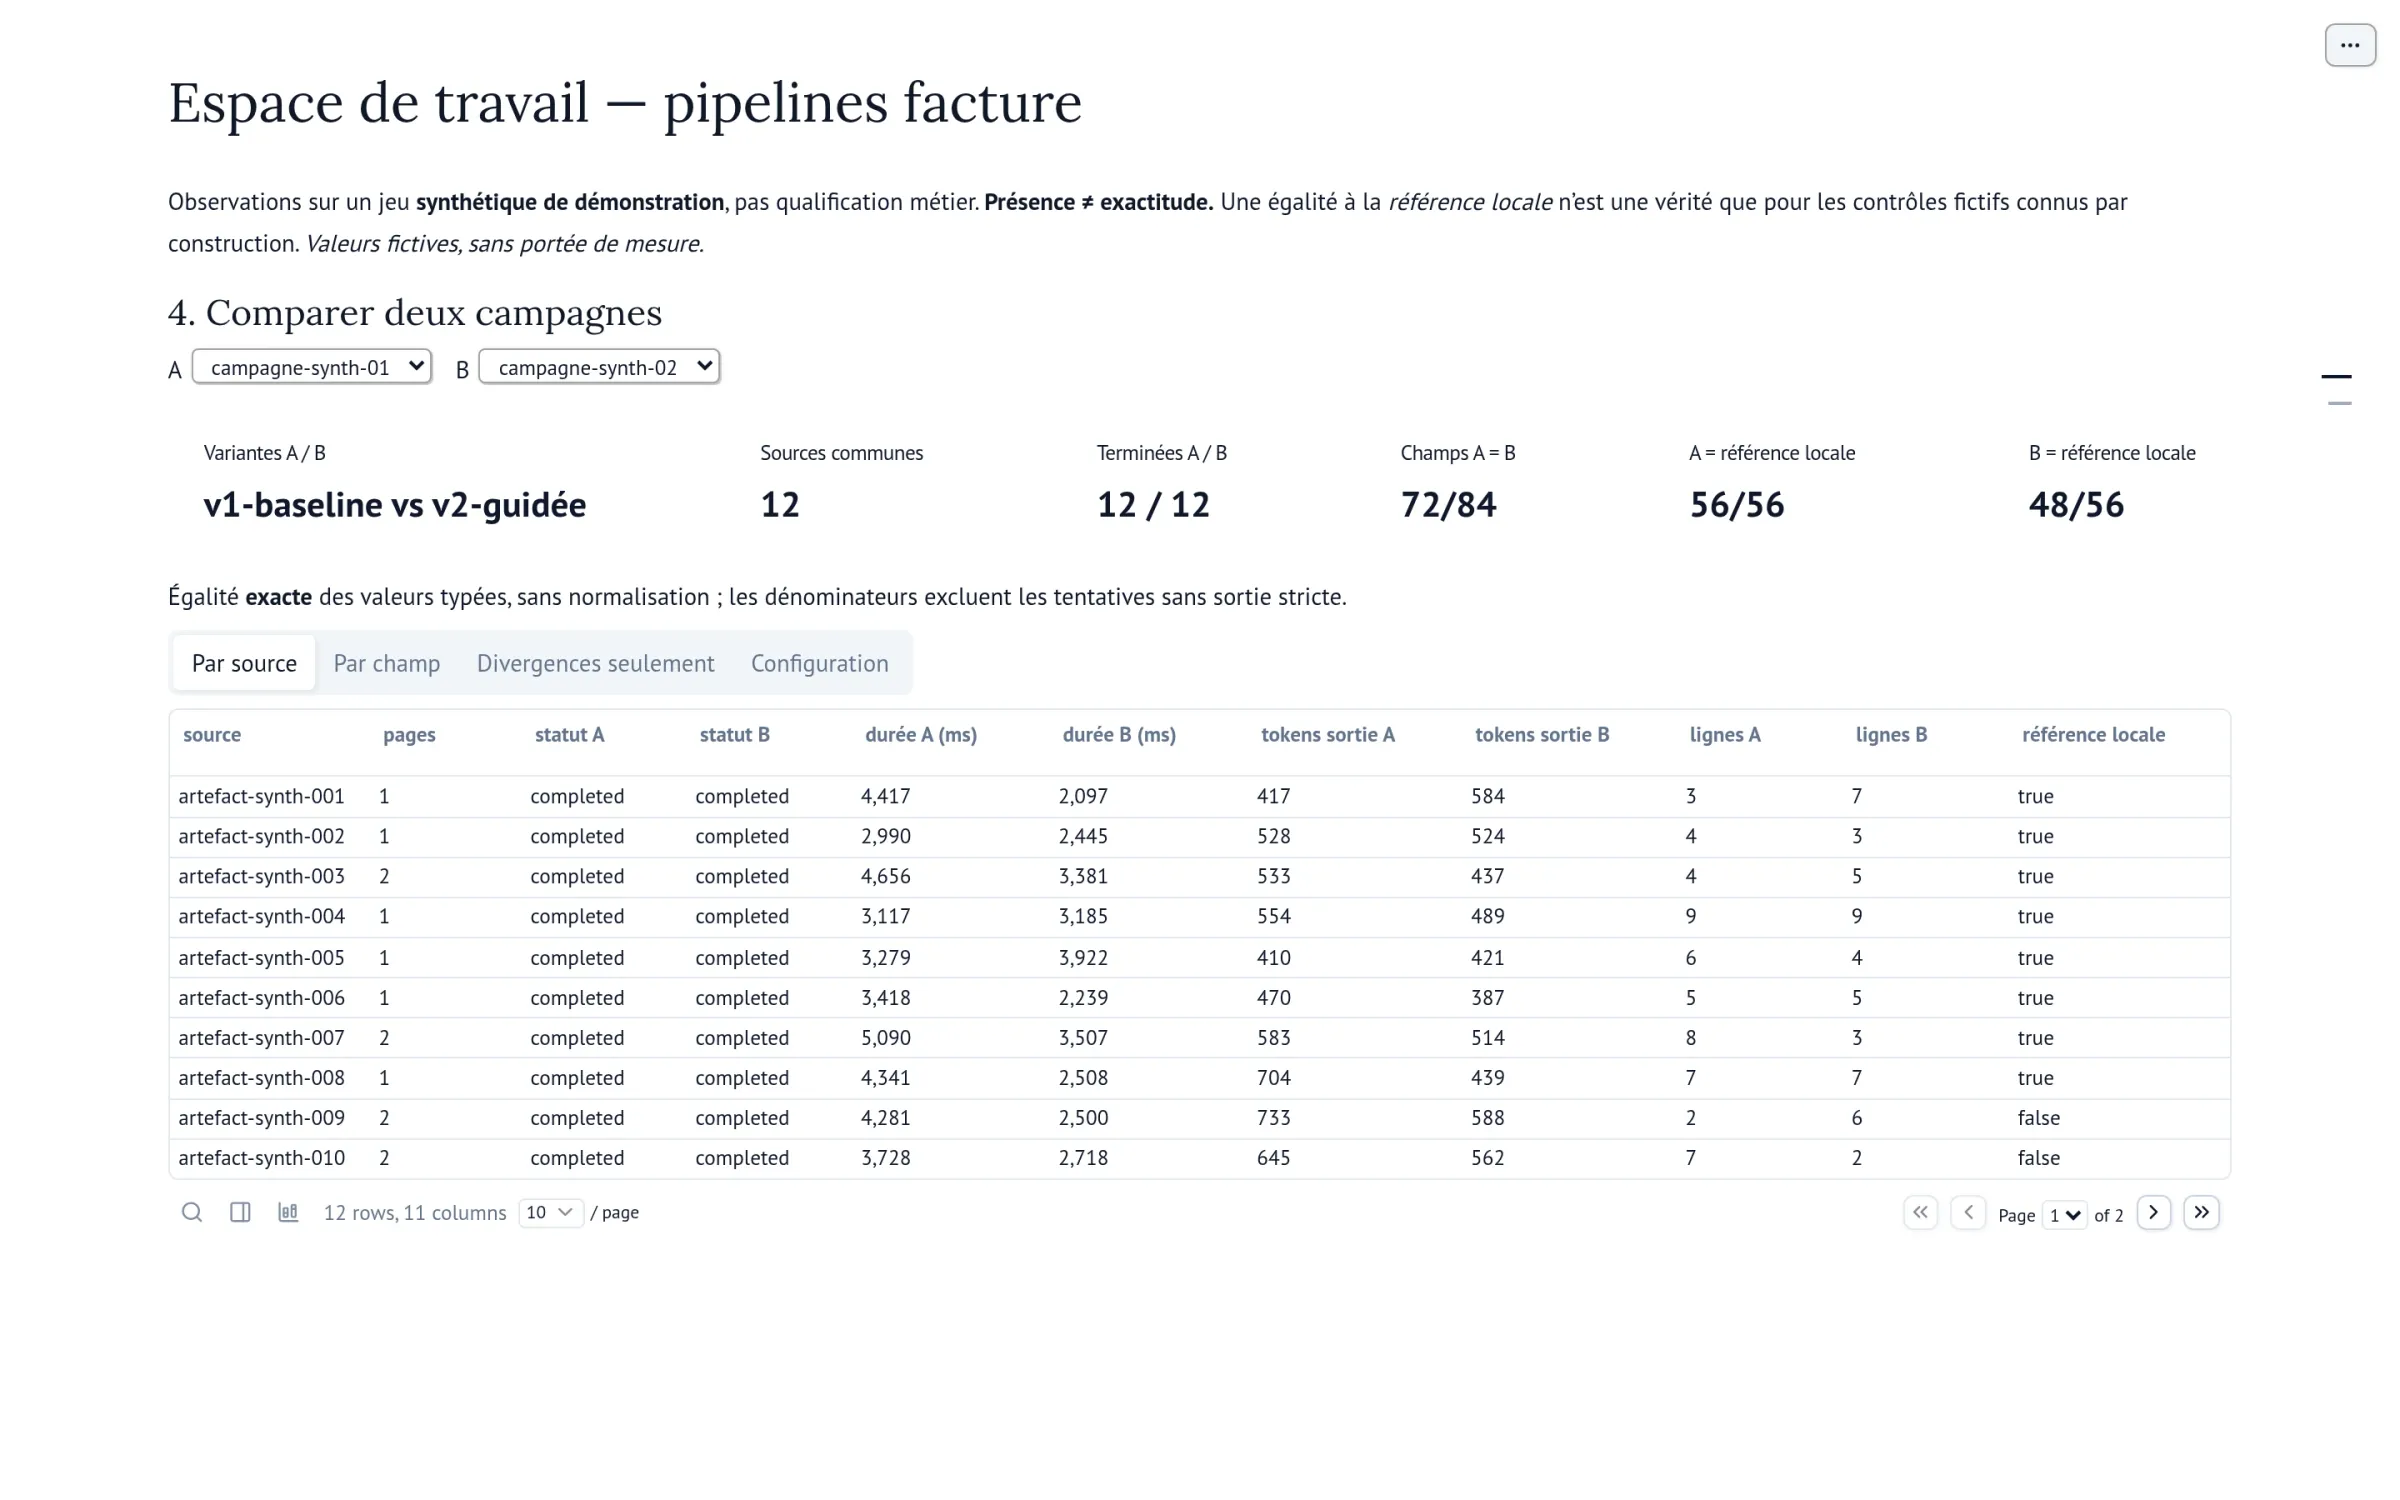
Le code est vérifié par une suite de tests automatisés3. Les comparaisons se lisent dans des carnets, à partir des artefacts immuables de chaque campagne.
206 tests passent en local au…
206 tests passent en local au 7 octobre 2026. Ils vérifient le code, pas la qualité de lecture.
- décisions d’architecture consignées
- 11
- tests automatisés qui passent en local
- 206
Ce que cela change
La question « faut-il sortir les données du poste ? » se tranche sur des mesures, pas sur une promesse commerciale. La cible du prochain banc d’essai, sur une infrastructure GPU dédiée, est décidée ; ses résultats alimenteront le choix entre traitement local, modèle open-weight hébergé et service externe, avec une rétention nulle si une API externe est retenue pour le banc.
Limites
- Aucun taux de reconnaissance n’est publié : les résultats du banc d’essai sur infrastructure dédiée ne sont pas encore disponibles.
- Les captures montrent l’outil d’annotation et un carnet de comparaison sur des données synthétiques, pas un produit fini.
- Les échantillons réels restent privés et ne sortent pas du cadre du client.
- Le système ne vérifie pas les droits et ne prend aucune décision automatisée.
Partager et réutiliser
Le lien, le texte brut et des visuels prêts pour LinkedIn.